Data Engineering
NYC Taxi ETL
9,17 M+ enregistrements, orchestrés de bout en bout et chargés 82 % plus vite.
- trajets de taxis new-yorkais traités
- 9,17 M+
- trajets de taxis new-yorkais traités
- de temps de chargement PostgreSQL (~51 → ~9 min)
- -82%
- de temps de chargement PostgreSQL (~51 → ~9 min)
- contrôles qualité & tableaux de bord KPI
- Automatisés
- contrôles qualité & tableaux de bord KPI
01 Contexte
Données des trajets des Yellow Taxis de New York (T1 2023), publiées par la NYC TLC au format Parquet. L'objectif : un workflow ETL de bout en bout, robuste, documenté et orchestré, construit comme le ferait une équipe data en production.
02 Problème
Des millions de trajets bruts doivent être ingérés, nettoyés et chargés dans PostgreSQL de façon fiable et rapide. Un chargement naïf prenait ~51 minutes, et sans contrôles automatisés rien ne garantit que les données qui alimentent les KPI sont saines.
03 Ce que j'ai construit
- 01
Extraction - téléchargement des fichiers Parquet de la NYC TLC dans une zone brute.
- 02
Transformation - nettoyage, filtres logiques, normalisation et dédoublonnage vers une zone propre.
- 03
Chargement - chargement PostgreSQL optimisé avec insertions par lots, index temporels et gestion VACUUM / ANALYZE.
- 04
Contrôles qualité - contrôles automatisés qui génèrent un rapport qualité en Markdown.
- 05
Analytique - vues matérialisées, exports de KPI et synthèses visuelles.
- 06
Orchestration - l'ensemble du pipeline tourne dans un seul flow Prefect 3.
04 En action
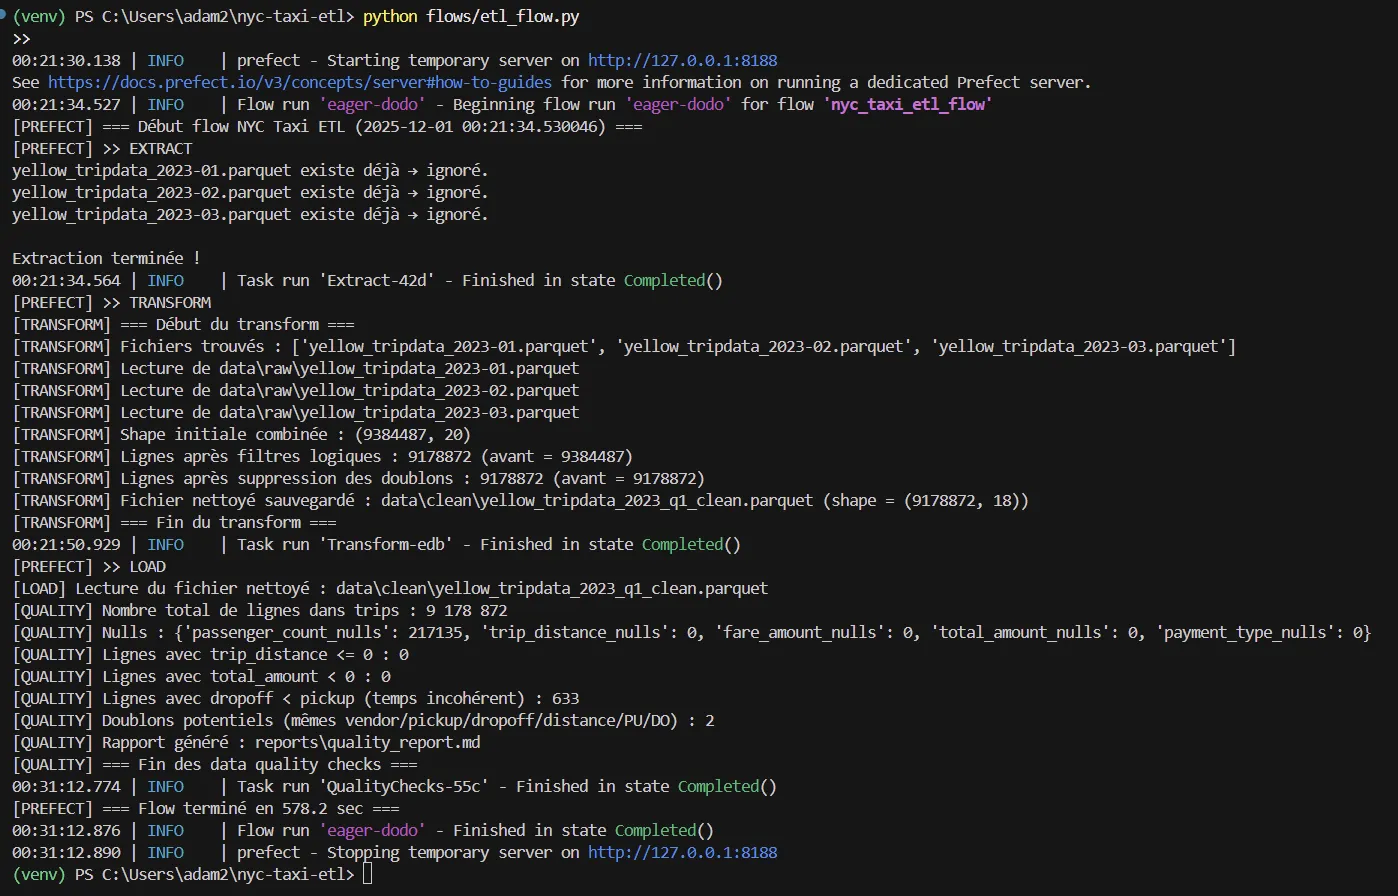
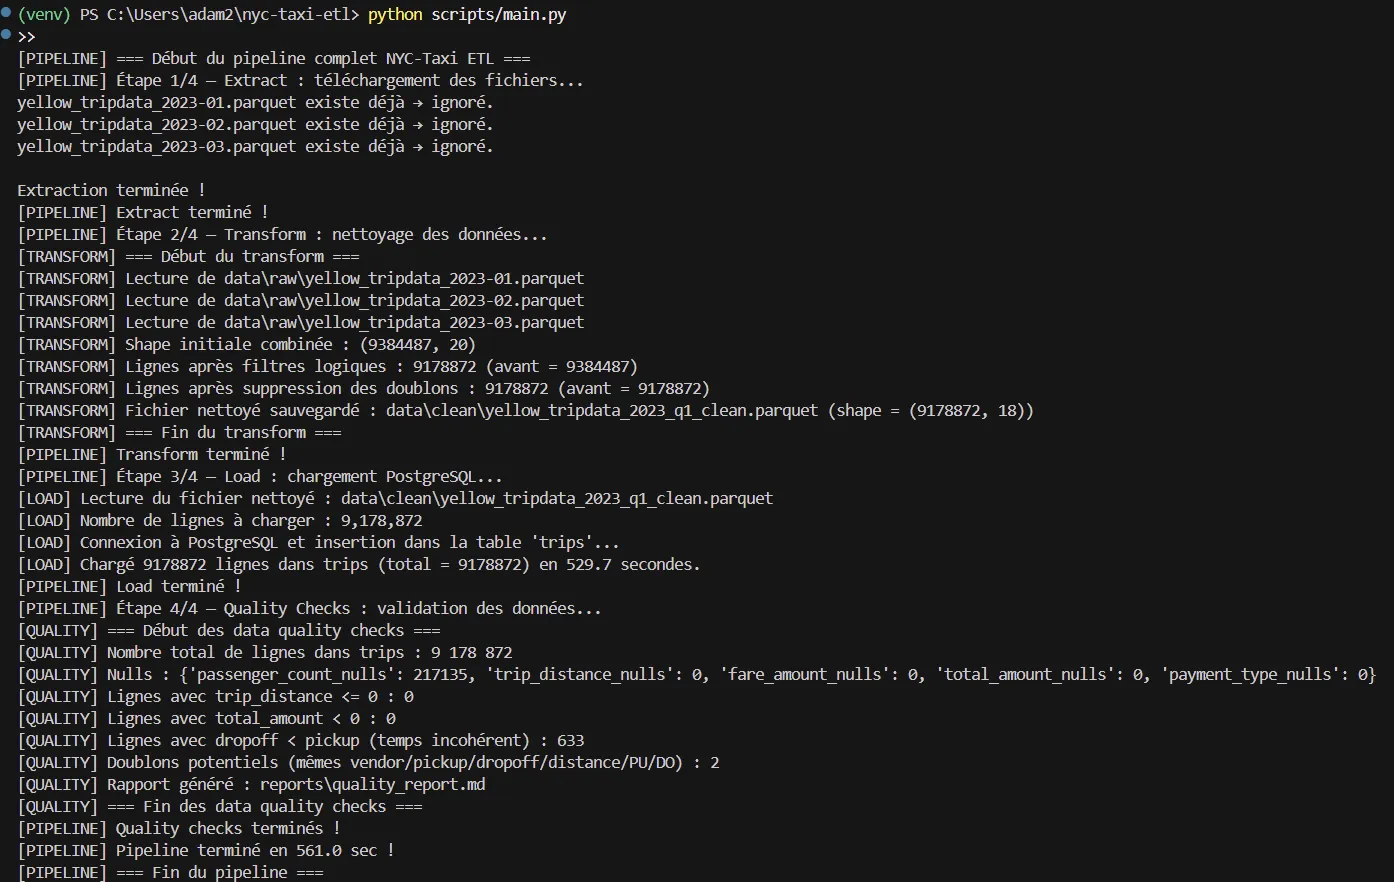
Captures issues du dépôt du projet.
05 Résultats
- trajets de taxis new-yorkais traités9,17 M+
- de temps de chargement PostgreSQL (~51 → ~9 min)-82%
- contrôles qualité & tableaux de bord KPIAutomatisés
06 Ce que j'ai appris
- La performance de chargement est un choix de conception : insertions par lots et gestion des index et du VACUUM / ANALYZE ont fait passer un chargement de ~51 minutes à ~9 minutes.
- L'orchestration rend un pipeline observable et relançable étape par étape, au lieu d'une chaîne fragile de scripts.
- Les contrôles qualité ont leur place dans le pipeline : un KPI n'est fiable que si les contrôles en amont le sont.
- Les vues matérialisées éloignent les analyses lourdes des tables brutes et rendent les dashboards rapides.
Étude de cas suivante
CloudPredict