Recherche vectorielle · ML
Materials Similarity Search
Des tableurs de labo éparpillés à une recherche de similarité en moins d'une seconde.
Réalisé pendant mon stage chez AptiSkills
- matériaux composites structurés (2 560 lignes brutes)
- 74
- matériaux composites structurés (2 560 lignes brutes)
- de variance expliquée (R²) sur la contrainte max
- 88%
- de variance expliquée (R²) sur la contrainte max
- de recherche de similarité sur 1 279 vecteurs
- <1 s
- de recherche de similarité sur 1 279 vecteurs
- de temps de recherche manuelle
- Heures → min
- de temps de recherche manuelle
01 Contexte
Stage R&D chez AptiSkills sur les matériaux composites polymères, prometteurs pour les réservoirs d'hydrogène de type IV/V et les environnements marins extrêmes (MHK). Données source : la MHK Materials Database des Sandia National Laboratories.
02 Problème
Les données expérimentales étaient dispersées dans des fichiers Excel multi-feuilles hétérogènes, non standardisés et difficiles à interroger. Les ingénieurs passaient des heures à chercher à la main des matériaux aux propriétés comparables.
03 Ce que j'ai construit
- 01
Nettoyage des données - extraction et normalisation de la base MHK multi-feuilles en un dataset propre.
- 02
Modèle relationnel - schéma SQLite Matériau / Résine / Essai, alimenté automatiquement.
- 03
Régression - pipeline scikit-learn (LinearRegression avec encodage one-hot) prédisant la contrainte maximale à partir du taux de fibre, du module d'Young, de la déformation max, de l'épaisseur, des cycles et du type de résine.
- 04
Recherche vectorielle - index FAISS L2 sur les vecteurs de matériaux normalisés.
- 05
Produit - une application Streamlit pour explorer, filtrer, analyser les performances mécaniques et trouver des matériaux similaires.
04 En action
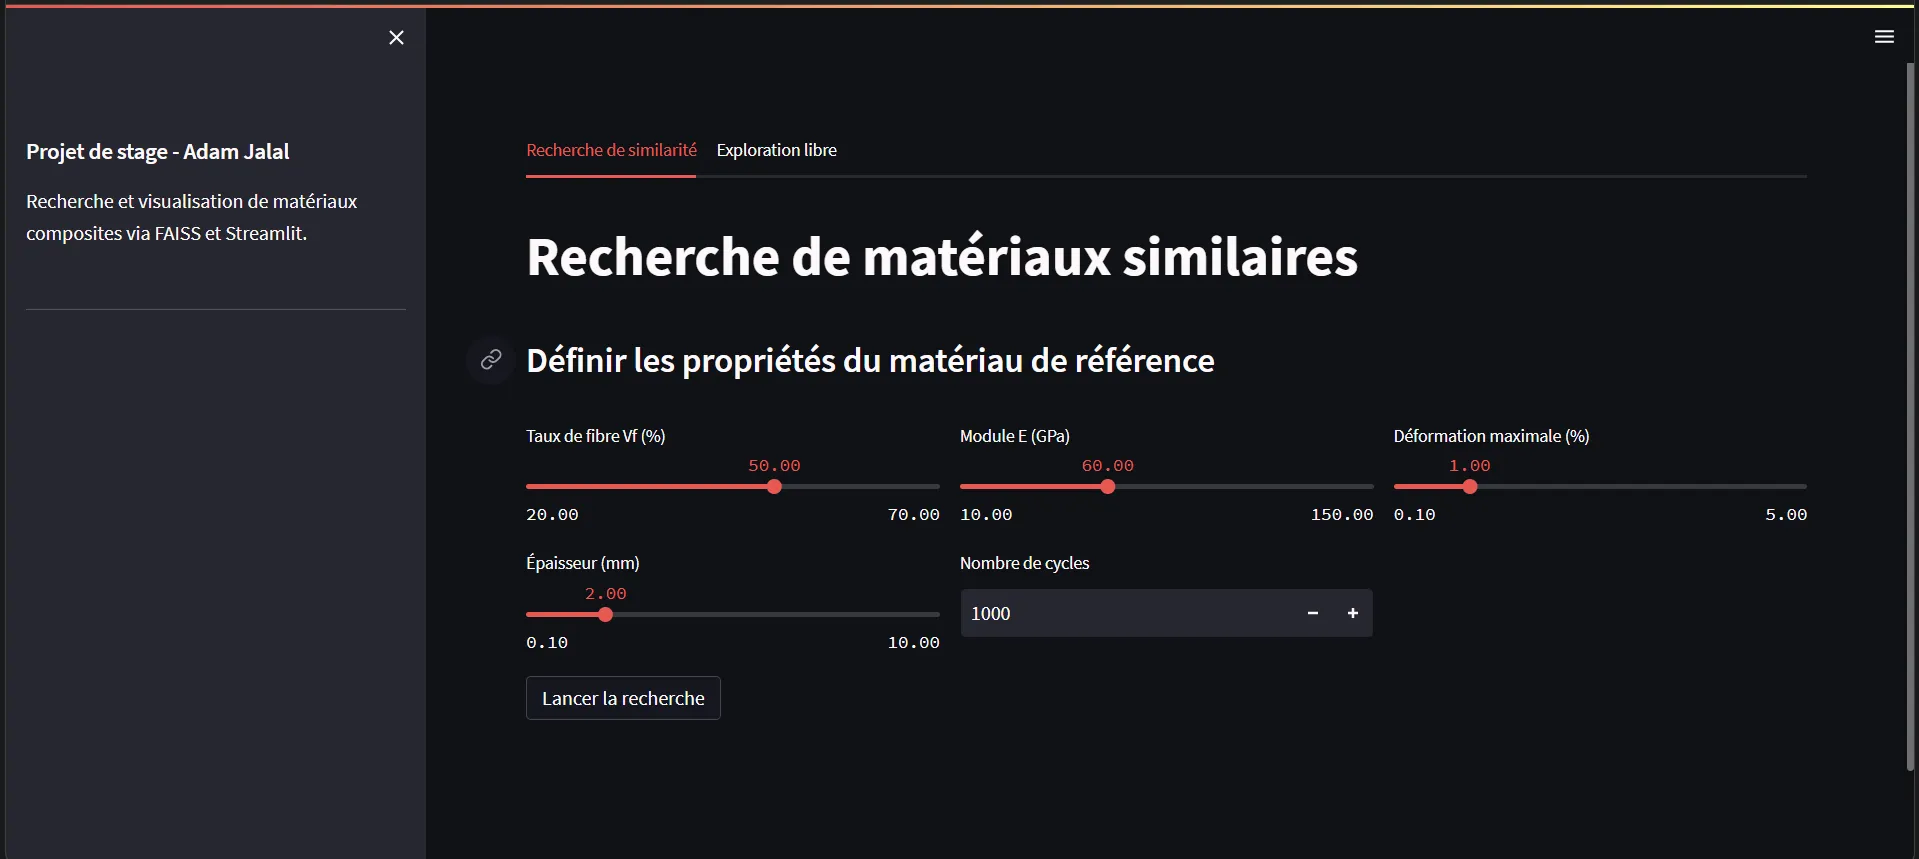
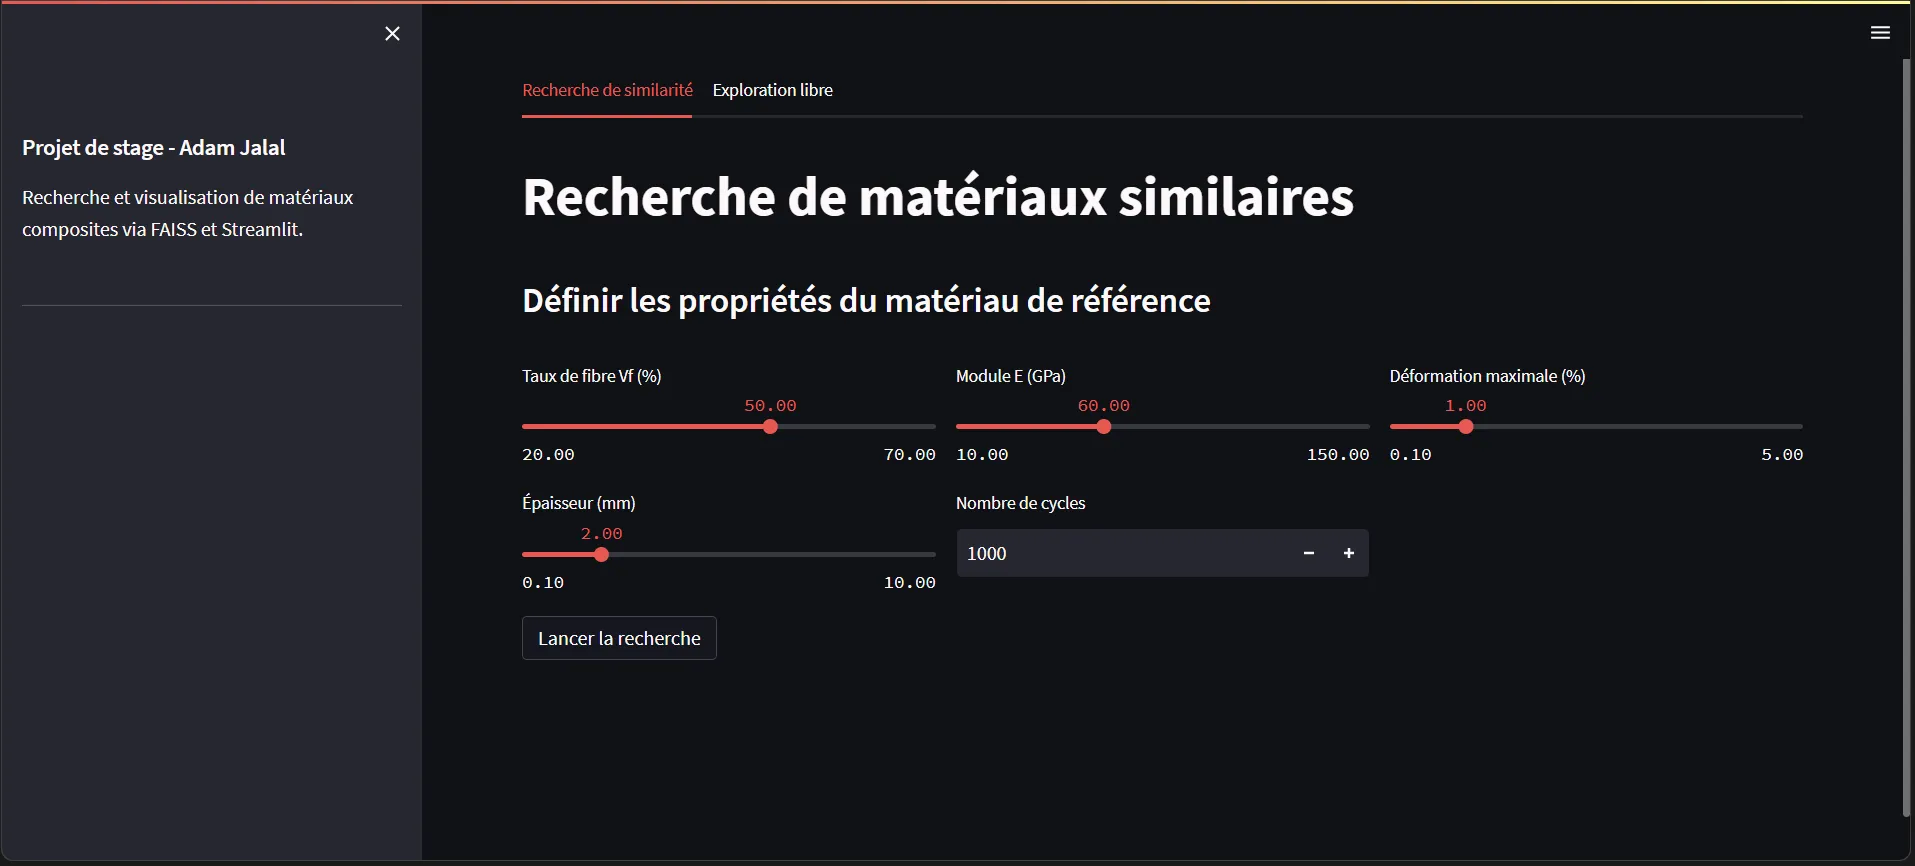
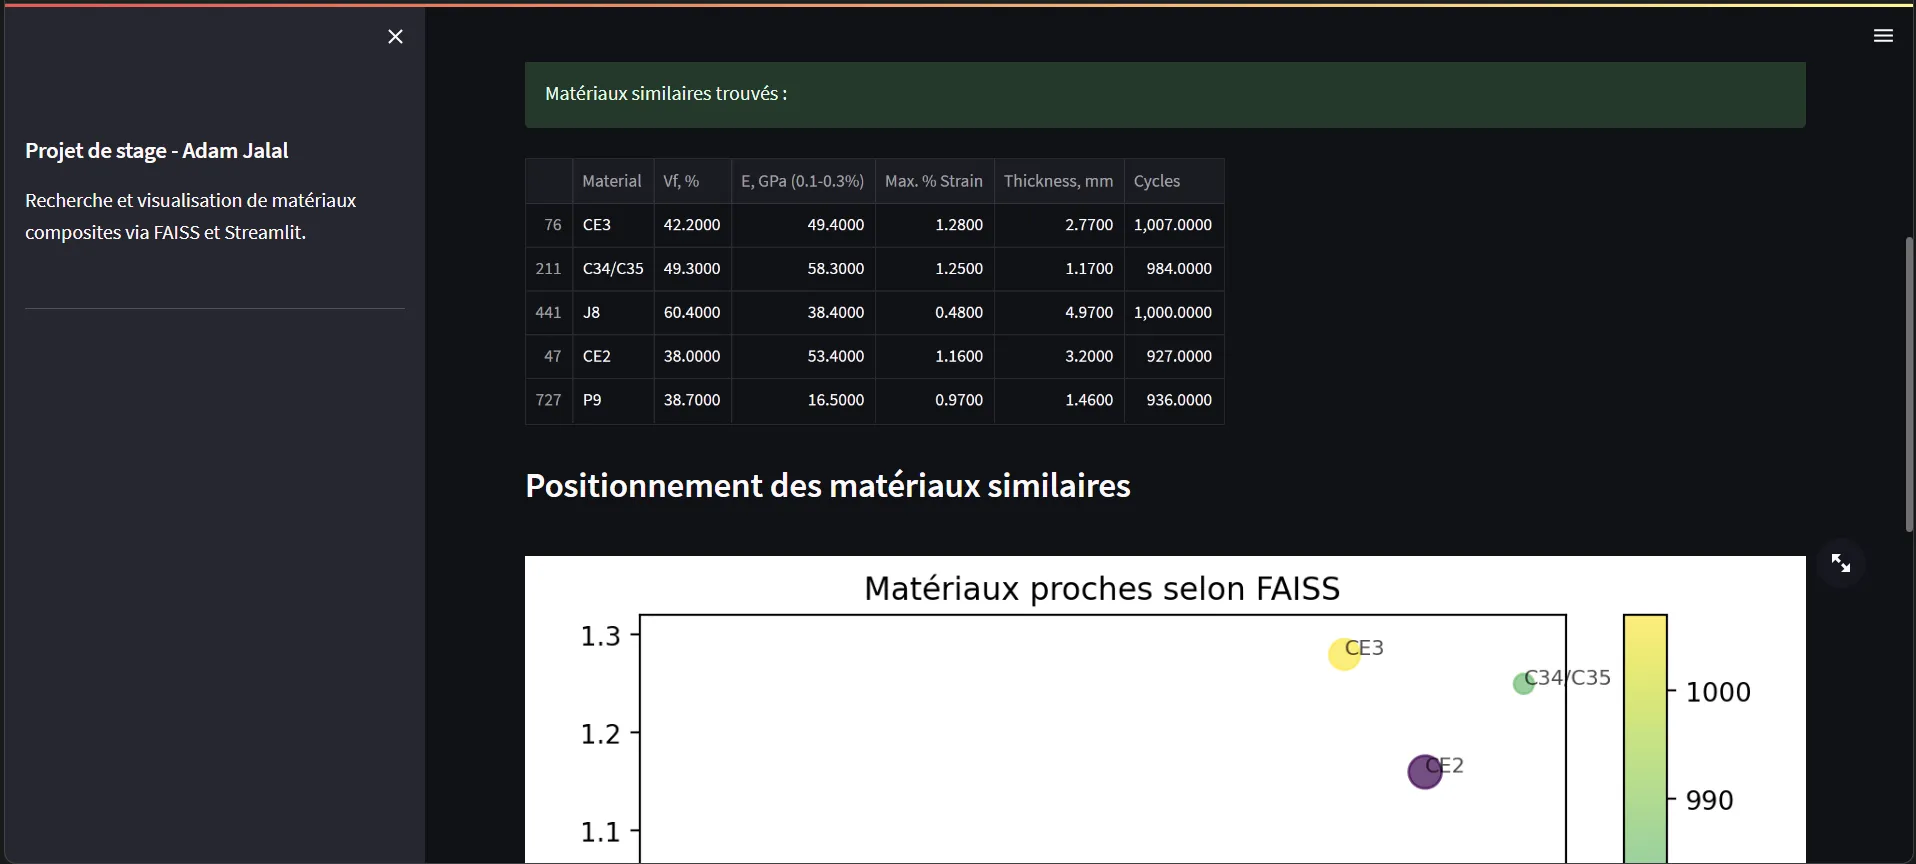
Captures issues du dépôt du projet.
05 Résultats
- matériaux composites structurés (2 560 lignes brutes)74
- de variance expliquée (R²) sur la contrainte max88%
- de recherche de similarité sur 1 279 vecteurs<1 s
- de temps de recherche manuelleHeures → min
06 Ce que j'ai appris
- Nettoyer des données multi-feuilles complexes et hétérogènes, puis les modéliser de façon relationnelle.
- La régression supervisée avec un pipeline scikit-learn complet et la standardisation des variables.
- La recherche vectorielle avec FAISS pour une similarité multidimensionnelle rapide.
- Concevoir un outil Streamlit autour du vrai quotidien des ingénieurs, et mener un sprint d'un mois avec des livrables hebdomadaires.
07 La suite
Material Discovery Engine
Une suite personnelle, en dehors du stage : le prototype Streamlit reconstruit en API REST prête pour la production.
- Recherche de similarité FAISS (IndexFlatL2) sur 3 819 matériaux composites
- 8 variables numériques normalisées avec StandardScaler
- API REST FastAPI avec documentation automatique
- Conteneurisation Docker
- 32 tests automatisés avec pytest, CI/CD GitHub Actions
- FastAPI
- FAISS
- SQLite
- Docker
- pytest
- GitHub Actions
Étude de cas suivante
NYC Taxi ETL